DeepSeek 又崩了:一次故障的两种解释
先摆事实
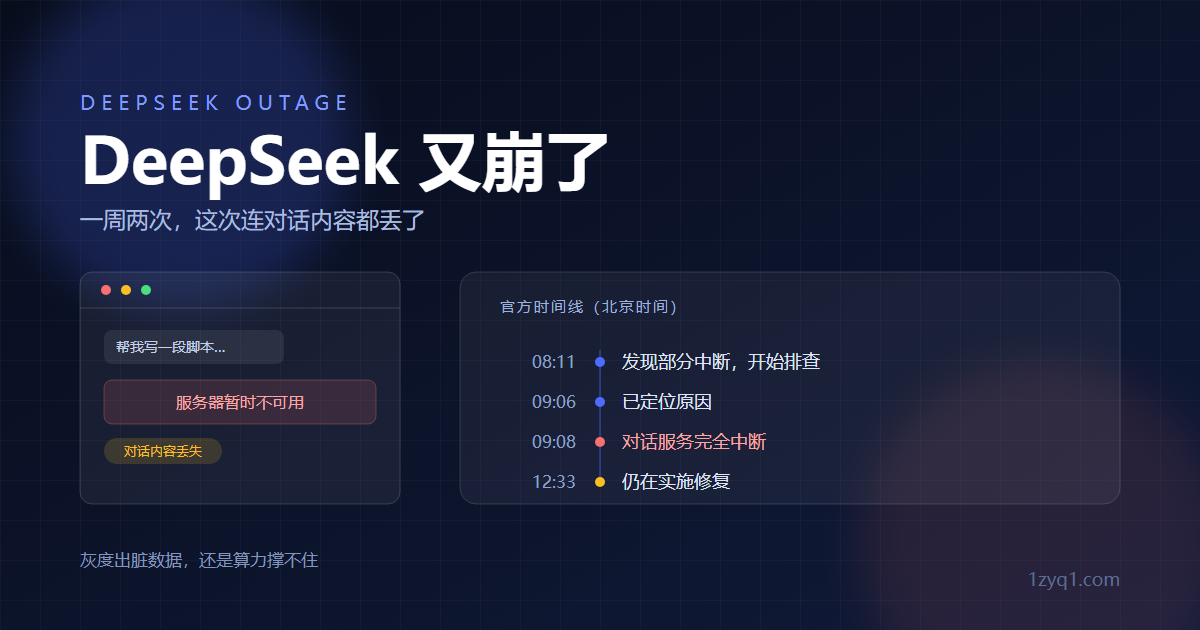
10 月 15 日早上 8:11,DeepSeek 官方状态页记录到网页端与 API 部分中断;9:06 状态更新为「已定位原因」;9:08 对话服务完全中断。到中午 12:33 再看,故障仍未标记为已解决。
官方列出的受影响组件有四个:
- 对话服务(Chat Service,共 3 个组件)
- DeepSeek V4 Pro API
- DeepSeek V4.1 Flash API
- 上传文件服务
用户侧看到的表现则五花八门:有人打开网页和 App 只得到一句「服务器暂时不可用」,发起不了新对话;有人卡在加载界面;有人收到「服务器繁忙」「消息过于频繁」;还有人反馈对话内容丢失。
最后这一条才是值得停下来的地方。「打不开」是可用性问题,而「内容丢失」不是 —— 那意味着有数据被写坏了。第三方故障监测平台 StatusGator 在过去 24 小时收到了 86 条报障,卢森堡、波兰、纽约的用户都在里面。
一周两次,这个节奏本身就有信息量
把最近一个月的公开运维记录排一下:
| 日期 | 时长 | 波及范围 |
|---|---|---|
| 10/2 | 1 小时 54 分 | V4 Pro API、V4.1 Flash API、对话服务 |
| 10/8 | 约 3 分钟 | 服务性能衰减 |
| 10/12 | 约 11 分 / 约 15 分(两起) | 对话服务;对话服务 + V4.1 Flash API |
| 10/15 | 3 小时以上(中午仍在修复) | 对话服务、V4 Pro API、V4.1 Flash API |
再往前,9 月累计 8 起异常事件,其中 9 月 14 日那次约 3 小时。有统计说 2026 年至今至少 18 次大面积异常。
官方状态页给 7 月—10 月的可用性数字是:V4.1 Flash API 99.46%,对话服务 99.44%,V4 Pro API 99.74%。这些数字单看不算难看,但换算一下就知道问题在哪 —— 99.4% 意味着一个月里累计有好几个小时是不可用的。对把 API 嵌进产品里的开发者来说,这个数字不够用。
猜想 A:灰度发布,写坏了数据
先说清楚:这是我的推测,官方没有确认。 但它值得认真对待,理由有三条。
第一,发布节奏对得上。 从 10 月 12 日起,多位海外独立测试者发现 DeepSeek 的 flash 端点疑似在幕后换了模型 —— 同样的 prompt,生成质量明显变好,社区猜测新版本可能是 V4.2-Flash 或 V4.1-Pro。也就是说,在这次故障发生前,这套系统正好处在「新旧模型同时在线」的状态里。
第二,周四这个时间点。 大多数团队把发布和灰度放在周中动手:周四上线,出问题周五还来得及修,周末可以退回稳定版本。今天正好是周四。
第三,「对话内容丢失」指向数据层,而不是容量层。 如果单纯是算力不够,用户看到的应该是排队、超时、限流报错;而「内容丢失」说明有写入发生了错乱。这是发布相关的典型特征。
灰度为什么会"脏"
把机制拆开,灰度期出一致性问题其实不难理解:
- 同一会话被路由到两套实例。 灰度时新旧版本同时在线,负载均衡可能把同一个会话的不同轮次打到不同实例上。两边的 KV cache 结构或 prompt 模板只要有差异,历史前缀就对不上,模型开始复读、答非所问,或者干脆丢掉前文。
- 流式响应被截断。 版本切换的瞬间连接断掉,服务端只吐了半个 JSON。客户端如果没有校验结束标记就把它当成完整回复存进会话,下一次请求就会带着这段残缺历史 —— 错误从此被「固化」。这是脏数据最经典的产生路径:一次不完整的写入,污染了后面所有请求。
- 路由表或模型注册表热更新出错。 灰度通常伴随配置热加载,配置读到一半,请求可能打到错误的端点,返回一个格式完全正确、内容却不属于该模型的结果。
- 计费与统计重复记账。 请求被重试、失败后又被上游补算,容易出现重复扣费或漏记。
猜想 B:算力供需失衡
这个解释更朴素,解释力可能还更强。
多家媒体在报道里都提到同一个背景:业界普遍认为 DeepSeek 稳定性问题的核心症结是算力供需失衡 —— 访问量持续上涨,而高端算力的采购和扩容周期很长。一个月崩一到两次、3 月底还有超过 12 小时的宕机,这个分布不太像偶发的发布事故,更像一个长期贴着满负荷运行的系统。
官方状态页的措辞也值得注意:是「部分中断」,不是「全部不可用」。一部分实例挂了、另一部分还在扛 —— 这个形态和「容量打满后部分实例被拖垮」是吻合的。
而且官方只公布了时间线和「已定位原因」,并未把故障归因于模型发布。
两个猜想怎么区分
比起猜,更有用的是知道怎么验证。下面这张表可以直接对着自己的日志看:
| 观察项 | 偏向「灰度 / 数据问题」 | 偏向「容量过载」 |
|---|---|---|
| 错误类型 | 5xx、JSON 解析失败、内容错乱 | 429、超时、排队 |
| 首 token 延迟 | 基本正常 | 明显拉长 |
model 字段回显 | 可能与请求不符 | 与请求一致 |
| 同一 prompt 复测 | 输出风格突变、前后不一致 | 输出正常,只是慢或失败 |
| 恢复后的历史会话 | 有残缺或错乱 | 完好 |
落地到操作上,成本最低的验证办法是记录 + 复测:
- 每次请求存下
request-id、时间戳、请求的 model、以及响应里回显的 model; - 准备一批固定 prompt,记录输出指纹(长度、开头 20 字、有没有正常的结束标记);
- 服务恢复后,用完全相同的参数再跑一遍,对比指纹。
三种结果对应三种结论:恢复后输出风格整体变了,那是模型换了;只有故障期的记录是残缺的,那是数据被写坏了;全都一致、只是当时超时失败,那就是容量问题。
给开发者的几条实操
我在自己的模型中转站里接过 DeepSeek 通道,这次故障正好把 failover 逻辑实战检验了一遍。
- 超时 + 指数退避重试,缺一不可。 而且只重试可重试的错误(429、5xx、连接超时),4xx 直接失败 —— 否则一次内容错误会被重试成十次重复计费。
- 流式响应必须校验完整性。 别把流拼起来就落库。检查有没有正常结束标记,没有就当失败丢弃,不要写进会话历史。
- 多供应商 failover 是刚需,不是优化项。 主通道挂了要有同级别模型的备用通道顶上。3 小时以上的故障,单供应商方案就是 3 小时直接不可用。
- 故障期不做写操作。 会话落库、积分扣减这类动作,宁可让用户重发,也不要在上游状态不明的时候写进去 —— 脏数据比报错难清理得多。
- 监控要把错误分类。 5xx、429、超时、解析失败分开统计。混进一个笼统的「错误率」里,你永远看不出是上游挂了还是自己的代码有问题。
最后
需要再说一遍:「灰度出脏数据」目前仍然只是猜想。 它之所以值得讨论,是因为「对话内容丢失」这个症状确实指向数据一致性,而不只是容量不足 —— 但官方并未确认,把它当成结论是不严谨的。
同样不能忽略的是,故障频率本身就说明了问题。一个月崩一到两次,无论原因是什么,都意味着把某一家当成唯一供应商是有风险的。真正能保护你的不是猜对原因,而是那次故障来的时候,你的系统不用跟着一起停。
事实部分来自 DeepSeek 官方状态页与公开报道;推测部分已在文中明确标注。
评论
登录(或注册)之后就能评论啦 —— 用邮箱或 GitHub 都行。